
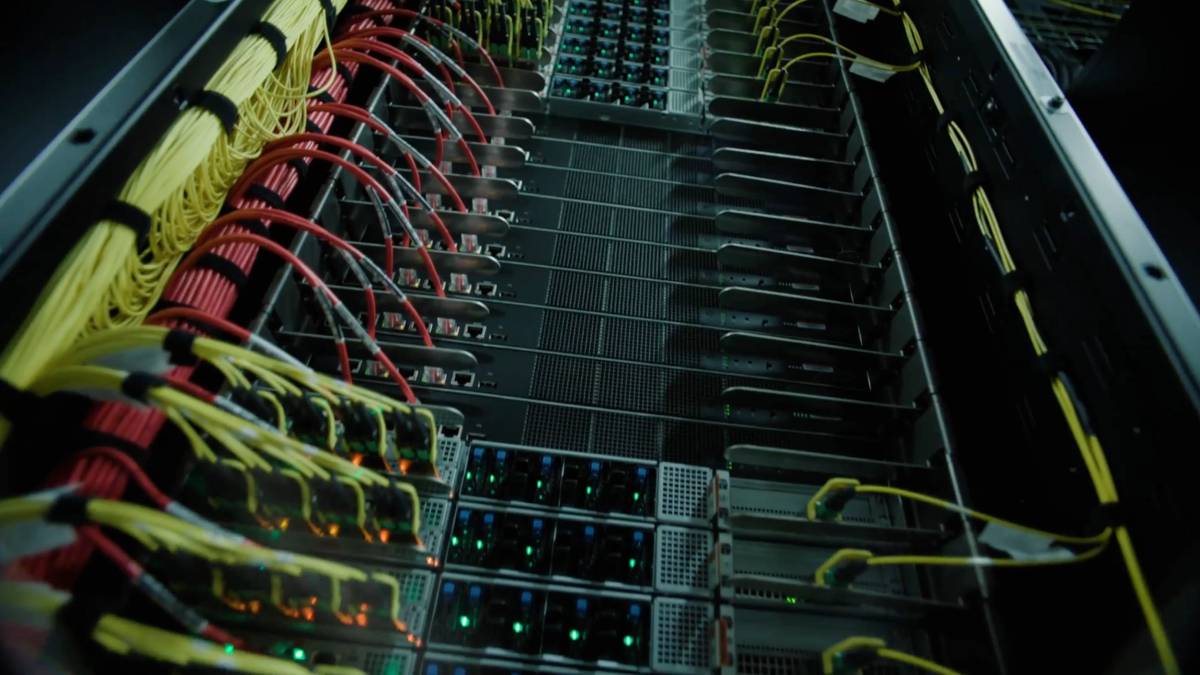
隨著AI模型規模越來越龐大,真正限制人工智慧發展的問題,已不只是晶片效能,而是「GPU之間如何高速傳輸資料」。
OpenAI近日正式宣布,攜手AMD、Broadcom(博通)、Intel、Microsoft與NVIDIA等科技巨頭,共同推出全新網路協定「MRC(Multipath Reliable Connection,多路徑可靠連線)」 ,希望解決大型AI超級電腦在訓練時的網路壅塞問題。
AI時代的新瓶頸:GPU彼此「溝通太慢」
OpenAI指出,當AI訓練規模擴大到超過10萬顆GPU時,即使只有少量資料傳輸延遲,也可能導致大量GPU閒置等待。
這種問題被稱為:
- 網路壅塞(Congestion)
- 延遲(Latency)
- 抖動(Jitter)
- 鏈路故障(Link Failure)
而這些狀況,會讓價值數十億美元的AI超算效率大幅下降。
OpenAI坦言,未來AI競爭已從「模型競賽」,逐漸變成「運算基礎建設競賽」。
MRC是什麼?
MRC全名為「Multipath Reliable Connection(多路徑可靠連線)」。
簡單來說,它是一種專門為AI超級電腦設計的新型網路協定。
過去資料傳輸通常只會走少數固定路徑,一旦塞車或故障,就可能拖慢整個AI訓練。
而MRC的核心概念是:
「把資料同時分散到數百條路徑傳輸」
這樣即使某些路線故障,也能立即切換其他路徑,幾乎不影響整體運算。
三大技術亮點
OpenAI表示,MRC有三大關鍵突破:
1/資料同時走數百條路徑
MRC能將單次資料傳輸拆散,分配到大量不同網路路徑中,大幅降低壅塞。
2/微秒級繞過故障
傳統大型資料中心若網路設備故障,可能需要數秒甚至數十秒重新路由。
但MRC能在「微秒級」完成切換。
這對同步式AI訓練極為重要。
3/降低超算耗電與設備數量
OpenAI表示,MRC可讓超大型AI叢集只需兩層交換器架構,就能維持高可靠度。
相較傳統三層或四層架構:
- 用電更低
- 成本更低
- 維護更簡單
已實際部署在OpenAI超級電腦
目前MRC已正式部署在:
- OpenAI最大規模NVIDIA GB200超算
- Oracle Cloud Infrastructure(OCI)
- Microsoft Fairwater超算系統
並已實際用於訓練OpenAI新一代模型。
OpenAI甚至透露,在某次模型訓練期間,他們曾直接重啟核心交換器,但AI訓練作業仍能持續進行。
OpenAI選擇「開源」
值得注意的是,OpenAI這次並未將技術封閉,而是透過OCP(Open Compute Project)向業界公開。
OpenAI表示:
「AI未來的基礎建設,需要產業共同合作。」
因此AMD、NVIDIA、Intel、Microsoft等公司都參與其中。
AI競爭正進入「系統戰爭」
外界分析,這代表AI產業競爭已開始從:
- 模型能力
- 參數規模
逐漸轉向:
- 網路架構
- 超算效率
- 資料傳輸
- 電力成本
- 散熱與基礎設施
因為未來真正的關鍵,可能不是誰有最多GPU,而是誰能讓GPU「不浪費時間等待」。